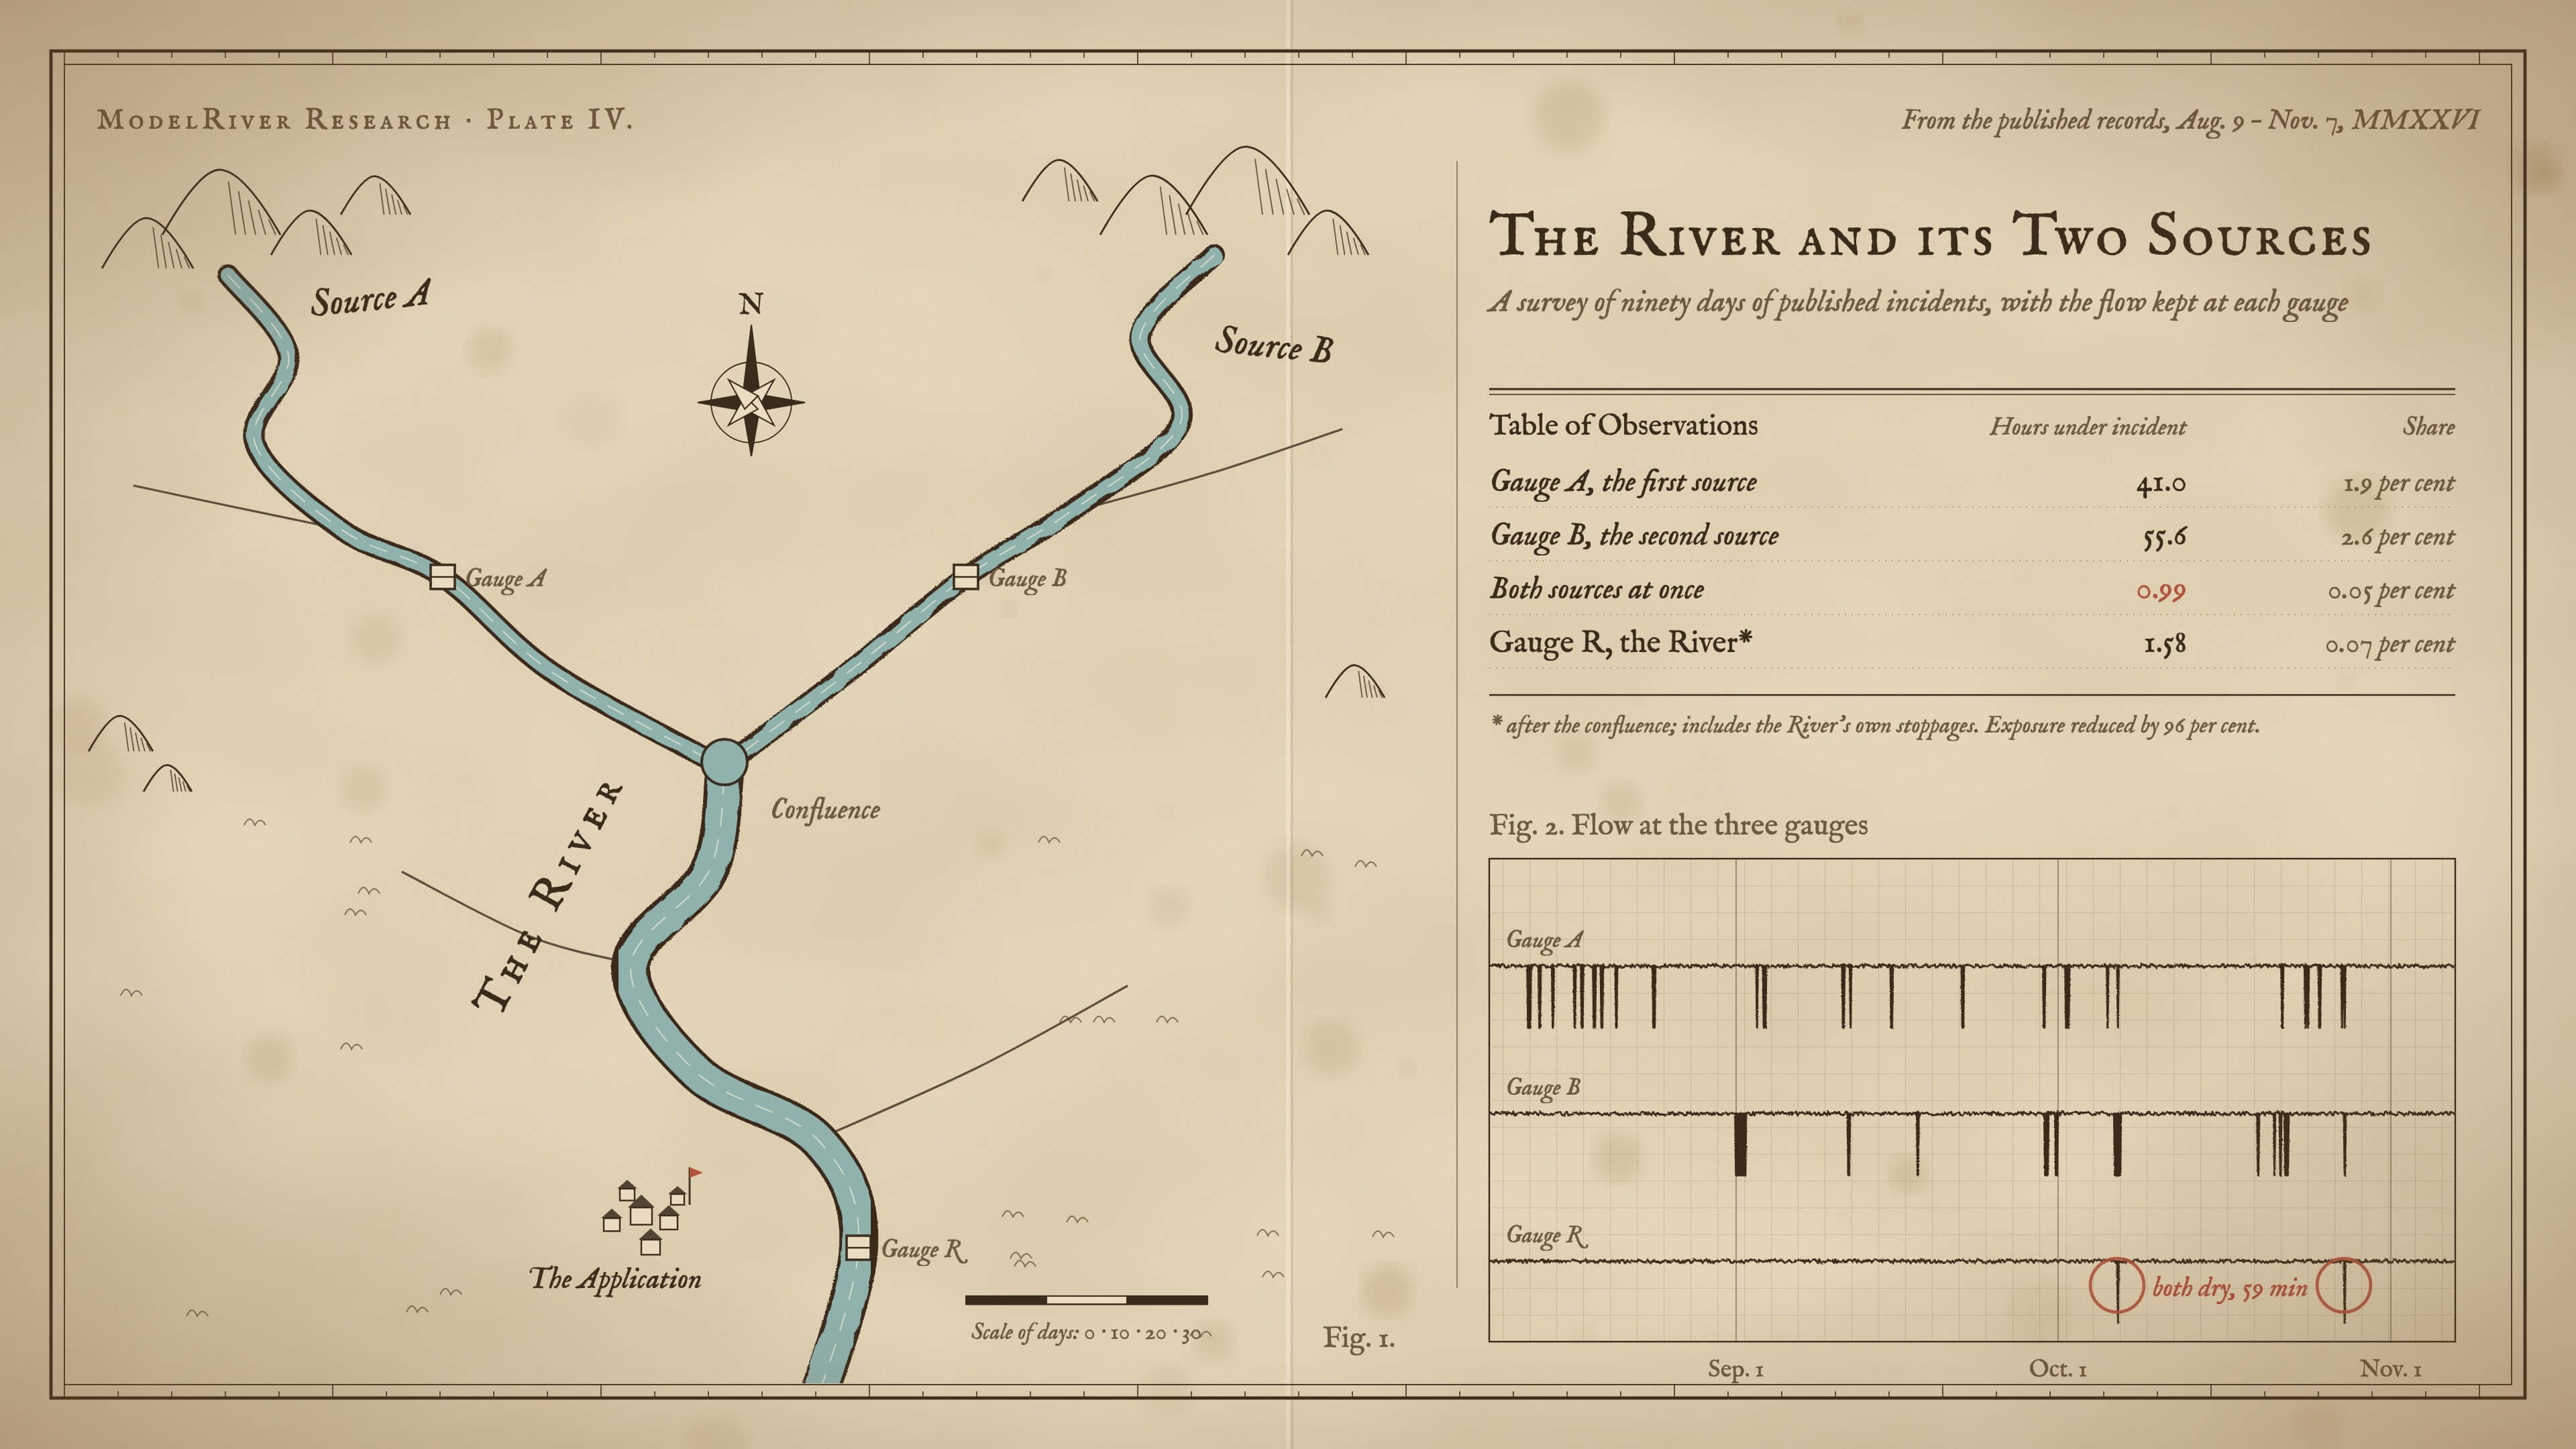
2026 年 8 月 9 日到 11 月 7 日之间,Anthropic 的 API 有 41.0 小时处于已公布的故障事件中,OpenAI 的文本生成 API 有 55.6 小时。两者重叠的时间只有 59 分钟 [1][2]。
这个差距一句话说明了为什么需要故障切换:AI 服务商经常出故障,但很少同时出故障。难的是如何利用这一点:在请求进行中把它转到另一家服务商,把答案送到一个可能已经离开的浏览器,并让你自己的后端在 AI 调用之间参与进来。大多数团队在第一次调用模型时,都没有为这些基础设施做准备。
我们做的正是这类基础设施。ModelRiver 是 AI 后端基础设施,分两层:
- 网关:在各服务商之间路由每个请求,负责故障切换、缓存、控制支出并记录成本。
- 编排:为请求排队,在 AI 步骤之间调用你的后端,并实时把结果送到浏览器。
所以我们做了测量:构建它需要什么,维持运行要花多少,每个请求背后发生了什么,以及它对可靠性有什么影响。凡是估算的数字,我们都给出公式和输入。
关键数字。每一项的方法和局限都在下文说明。
摘要
- 跨两家服务商的故障切换,让暴露在服务商故障中的时间减少了 96%。以 Anthropic 为主、OpenAI 为备,90 天里没有健康服务商可用的时间从 41.0 小时降到 1.58 小时。这个数字已经计入了 ModelRiver 自身的停机时间 [1][2][3]。
- 主模型失败的每个请求都拿到了答案。在我们的基准测试中,450 个这样的请求有 450 个得到答案,每次切换中位增加 18.4 ms [4]。
- 自己构建核心部分,需要几个月到几年的工程投入。带故障切换的路由、异步推送、签名 Webhook 和编排,我们实际花了 84 个工程师日。一个公开的标准估算模型(COCOMO II)对同样的代码估算为 1,259 个工程师日。按美国软件开发人员薪资中位数计算,这是 43,932 到 658,457 美元,还不包括后续维护 [4][5][6]。
- 你的代码量很小。在基于 ModelRiver 构建的生产应用 Desk 中,集成代码占全部代码的 1.0%,把所有用到它的文件都算上也只有 15.5%。没有 ModelRiver,Desk 所依赖的基础设施最多可能占到合并代码库的 44% [4][7]。
- 多出的一跳很短。在一台笔记本上使用生产设置,ModelRiver 让每个请求的中位耗时增加 33.2 ms [4]。
- 相比工程投入,价格很低。ModelRiver 的 Pro 套餐每月 49 美元,含 50 万次请求。如果分别租用你要自己拼接的那些组件,每月要 26.50–75 美元,这还不算任何工程投入 [8]–[13]。
调用模型之后发生了什么
教程里的模型调用只是一次 HTTP 请求。产品里的模型调用通常会变成一条小流水线:
- 你的应用发出请求。如果有人在页面上等待,请求应当立即返回,答案稍后送达。
- 网关根据工作流设置选择服务商和模型。它先检查支出上限和输入规则,再调用服务商。
- 服务商失败时,网关先重试断开的连接,再在同一个请求内切换到备用模型,备用模型可以属于另一家服务商。
- 编排层接手。
- 对于异步请求,它把任务放进队列,并给浏览器一个短期、只能用一次的令牌用于监听。
- 如果工作流需要你的数据或规则,它会向你的后端发送签名 Webhook,在时限内等待你的回调,然后继续下一个 AI 步骤或结束。
- 结果被实时送到浏览器、以 Webhook 送到你的后端,或两者都送。这包括晚连上的浏览器,以及被服务器重启中断的任务。
我们通过本地 ModelRiver 服务器把每种请求各发一次,统计它在背后触发了什么:
| 请求类型 | 服务商调用 | 后台任务 | 数据库记录 | 发给你后端的 Webhook | 推送给浏览器的实时更新 |
|---|---|---|---|---|---|
| 同步请求 | 1 | 0 | 1 | 0 | — |
| 同步,主模型失败 | 2 | 0 | 2 | 0 | — |
| 异步 + Webhook | 1 | 2 (1× AI 调用、1× Webhook 投递) | 2 | 1 | 1 |
| 编排:AI → 你的后端 → 结果 | 1 | 5 (1× AI 调用、3× 回调超时检查、1× Webhook 投递) | 3 | 1 | 4 |
对你来说,一个编排请求只是一次 API 调用加一个 Webhook 处理函数。在背后,ModelRiver 运行了 5 个后台任务,写入 3 条记录,签名并投递了一个 Webhook,等待你的后端回应,再向浏览器推送了 4 次实时更新。没有 ModelRiver,这里的每一块都需要你自己编写、部署和监控。
41 小时与 1 小时:故障切换带来了什么
图 1. 各服务商自己的状态页上公布的 API 故障事件,2026 年 8 月 9 日到 11 月 7 日。
我们取了每家服务商在这 90 天里公布的所有事件,并合并重叠的事件,避免同一小时被重复计算 [1][2]:
| Anthropic API | OpenAI 文本生成(Chat Completions + Responses) | |
|---|---|---|
| 事件数 | 29 | 11 段(OpenAI 所有 API 组件共 18 起事件) |
| 处于故障事件中的小时数 | 41.0 | 55.6 |
| 占 90 天的比例 | 1.9% | 2.6% |
| 两家同时处于故障事件中的小时数 | 0.99(两段:10 月 6 日 18 分钟,10 月 27 日 41 分钟) | 同左 |
网关本身也是依赖,必须算进去。ModelRiver 的公开状态页每分钟检查一次 API 和数据库。同样的 90 天里,它记录的可用性为 99.97% [3]:35 次检查失败,约 35 分钟。把这段停机时间按最坏情况加进去,结果如下:
| 没有健康路径可用的时间 | 占 90 天的比例 | |
|---|---|---|
| 只用 Anthropic,无故障切换 | 41.0 小时 | 1.9% |
| 经 ModelRiver,Anthropic → OpenAI | 1.58 小时 | 0.07% |
| 减少 | 96% | |
| 只用 OpenAI,无故障切换 | 55.6 小时 | 2.6% |
| 经 ModelRiver,OpenAI → Anthropic | 1.58 小时 | 0.07% |
| 减少 | 97% |
这对你的错误率意味着什么,不意味着什么。
- 这不是按请求计算的错误率。服务商不公布按请求计算的错误率,而一次"事件"可能只是少量请求失败,也可能是完全宕机。处于事件中的小时数是请求受影响时间的上限。
- 故障切换只能挽救应当转到另一个模型的错误:网络错误、限流(429)、服务器错误(5xx)、超时和模型不存在。如果服务商只是变慢,要等你的超时触发后才会被挽救。
- 备用模型不是同一个模型。它的回答可能不同,我们在生产环境里的 LLM Failover中讨论过。
- Google 没有计入重叠分析。Google AI Studio 的状态页在此期间列出 3 起 Gemini API 事件,包括 10 月 30 日约 2.5 小时"所有使用 API 密钥的请求"都失败的故障,但它不提供机器可读的时间段 [14]。
另一半问题是,需要时故障切换是否真的有效。我们配置了主模型总是失败的工作流,并与正常请求交替发送 [4]:
| 场景(150 轮,交替进行) | 调用方拿到答案 | 中位数(ms) | p95(ms) | 相比同一轮正常请求的增加,中位数(p95) |
|---|---|---|---|---|
| 主模型正常 | 150/150 | 236 | 242 | — |
| 主模型返回 500 → 备用 | 150/150 | 253 | 268 | +18.4 (+32.6) |
| 主模型返回 429 → 备用 | 150/150 | 253 | 267 | +18.3 (+32.6) |
| 主模型 500、备用 1 返回 503 → 备用 2 | 150/150 | 270 | 295 | +35 (+57.3) |
主模型失败的 450 个请求中有 450 个由备用模型给出了答案,背后是 600 次失败的服务商调用。调用方收到 HTTP 200,同时附带一份尝试记录,所以故障在你的日志里仍然可见。
构建它需要什么
下面是 ModelRiver 中十一个处理请求的功能,以及每个功能所需的代码和测试 [4]。代码行数取决于编程语言,请把它们当作相对规模来看。我们的实现使用一种简洁的函数式语言,换成其他技术栈会有所不同。
图 2. ModelRiver 中每个功能的代码行数,取自一个 git 提交(2026 年 11 月)。青色为生产代码,橙色为测试。
| 功能 | 生产代码行数 | 测试行数 | 已做的决定 | 后台任务类型 | 内存缓存 | 数据库表 |
|---|---|---|---|---|---|---|
| 多服务商路由 + 故障切换 | 8,726 | 4,497 | 12 | 0 | 0 | 3 |
| 异步请求 + 实时推送到浏览器 | 6,824 | 2,614 | 13 | 3 | 2 | 2 |
| 签名 Webhook + 重试 | 2,324 | 5,659 | 9 | 1 | 0 | 3 |
| 编排:在 AI 步骤之间调用你的后端 | 3,500 | 3,067 | 5 | 2 | 1 | 4 |
| 流式输出 | 2,881 | 544 | 8 | 0 | 0 | 0 |
| 对话记忆 | 2,244 | 3,530 | 6 | 0 | 0 | 3 |
| 响应缓存 | 694 | 961 | 3 | 0 | 1 | 1 |
| 结构化输出校验 | 499 | 580 | 1 | 0 | 0 | 1 |
| 支出上限 | 1,502 | 844 | 5 | 0 | 1 | 1 |
| 输入安全检查 | 1,408 | 1,539 | 9 | 0 | 2 | 1 |
| 请求日志 + 成本统计 | 1,595 | 562 | 3 | 1 | 0 | 4 |
| 十一个功能合计 | 32,197 | 24,397 | 74 | 7 | 7 | 16 张不同的表 |
代码行数只是看得见的部分,更难的是其中包含的 74 项决定。我们逐一列出,并由脚本核对每个取值确实出现在所引用的那一行代码上。部分示例:
| 方面 | 决定 | ModelRiver 的做法 |
|---|---|---|
| 实时推送 | 浏览器监听令牌的有效期 | 5 分钟,只能用一次,使用的瞬间即被删除 |
| 实时推送 | AI 在浏览器连上之前就完成了怎么办 | 结果保留 10 分钟,浏览器连上后推送 |
| 异步任务 | 失败的 AI 任务是否重试 | 不重试:重试会再次调用服务商,并重复计费 |
| 异步任务 | 服务器重启后遗留的任务怎么办 | 30 分钟后接管,并通知浏览器任务被中断 |
| 故障切换 | 哪些错误会切到备用模型 | 网络错误、429、所有 5xx、408、404;凭证错误仅在备用模型属于另一家服务商时切换 |
| 故障切换 | 连接断开怎么办 | 先重试两次,间隔 250 ms,再切换 |
| Webhook | 你的后端如何确认发送方是真的 | 对时间戳和负载做 HMAC-SHA256,放在请求头中发送 |
| Webhook | 投递尝试几次 | 3 次,间隔约 20 秒,之后标记为失败 |
| Webhook | 是否拒绝内网地址 | 是,每次发送都会检查 |
| 编排 | 等待你的后端回调多久 | 10 分钟,超时后向浏览器返回超时错误 |
| 流式输出 | 如何防止代理切断安静的流 | 每 15 秒发送一次心跳 |
| 记忆 | 如何防止两个请求覆盖同一份对话摘要 | 基于版本号的比较并交换 |
这些选择单独看都不难,难的是知道它们需要被做出,而其中很多是从故障中学到的。同一批文件的 git 历史说明了这一点 [4]:
- 12 个月里有 160 次提交,其中 48 次(30%)标为修复。
- 最近 90 天有 57 次。
| 功能 | 提交数 | 标为修复 | 修复占比 | 开始修改于 |
|---|---|---|---|---|
| 多服务商路由 + 故障切换 | 65 | 17 | 26% | 2025-11 |
| 异步请求 + 实时推送到浏览器 | 91 | 33 | 36% | 2025-11 |
| 签名 Webhook + 重试 | 22 | 9 | 41% | 2025-11 |
| 编排:在 AI 步骤之间调用你的后端 | 35 | 10 | 29% | 2026-01 |
| 流式输出 | 25 | 4 | 16% | 2026-05 |
| 对话记忆 | 17 | 5 | 29% | 2026-08 |
| 响应缓存 | 9 | 1 | 11% | 2025-11 |
| 结构化输出校验 | 3 | 1 | 33% | 2026-08 |
| 支出上限 | 7 | 0 | 0% | 2026-07 |
| 输入安全检查 | 9 | 2 | 22% | 2026-06 |
| 请求日志 + 成本统计 | 33 | 2 | 6% | 2025-11 |
部分修复(引自提交信息原文):"close retry races"、"Fix callback race condition"、"resume stuck callback_ai"、"Fix websocket socket ID collision"、"normalize JSON schemas for structured output"。每一条都是自建团队同样要学到的生产教训。
成本:构建、维护、租用
你的团队要花多少取决于你的团队,所以我们给出下限、上限和公式,你可以代入自己的费率。
构建核心部分。核心部分包括带故障切换的路由、异步推送、签名 Webhook 和编排:21,374 行生产代码(去掉注释和空行为 16,991 行),加上 15,837 行测试。
| 下限:我们的实际投入 | 上限:公开的估算模型(COCOMO II) | |
|---|---|---|
| 工程师日 | 84(约 4 个工程师月) | 1,259(66.3 人月,约 60 个工程师月) |
| 日历时间 | 分散在 12 个月中,与其他工作并行 | 按模型排期 13.9 个月 |
| 按美国薪资中位数(每个工作日 523 美元) | 43,932 美元 | 658,457 美元 |
- 下限统计的是我们的工程师向这些文件提交改动的天数。他们使用 AI 编程助手,并且清楚要构建什么。没有提交的设计、调试和运维时间没有计入,所以这是最小值。
- 上限是 COCOMO II,一个被广泛使用、公开发布的软件成本模型,所有设置都取"名义值"。它是用 AI 编程助手出现之前的项目校准的,所以应视为上限 [5]。
- 从零开始构建的团队会落在两者之间。
- 日费率是美国劳工统计局(BLS)2025 年 5 月软件开发人员年薪中位数 135,980 美元,除以 260 个工作日。这只是工资:雇主税费、福利和招聘成本另算 [6]。
维持运行。上线后维护不会停止:
| 每年工程师日 | 按美国薪资中位数 | |
|---|---|---|
| 仅修复(标为修复的提交,最近 90 天按年折算) | 24 | 12,552 美元 |
| 这些文件上的全部工作,含新功能(最近 90 天按年折算) | 104 | 54,392 美元 |
租用组件。其中一部分有现成的托管服务。按每月 10 万次 AI 请求、每次一条实时更新和一个 Webhook、高峰时 500 个浏览器同时在线计算:
| 用途 | 能满足需求的最便宜方案(标价,2026 年 11 月 7 日) |
|---|---|
| 向浏览器实时推送 | Supabase Pro 每月 25 美元起(500 个峰值连接正好是其上限)[9];Pusher Channels Startup 每月 49 美元 [10] |
| 任务队列 | Upstash QStash 每月约 1 美元(不含重试)[11] |
| Webhook 投递 | Hookdeck Outpost 每月 0.50 美元(无 SLA)[12],或 Svix Basic 每月 25 美元(99.9% SLA)[13] |
这些组件每月 26.50–75 美元。路由、故障切换、编排以及把它们连起来的代码仍然要你自己写,运行它们的服务器也要你自己提供。
合在一起看。第一年,按下限计算:
| 不用 ModelRiver(下限) | 使用 ModelRiver Pro | |
|---|---|---|
| 构建 | 43,932 美元 | — |
| 第一年修复 | 12,552 美元 | — |
| 租用的服务 | 318–900 美元 | — |
| 订阅 | — | 588 美元(49 × 12,每月最多 50 万次请求)[8] |
| 第一年合计 | 56,802–57,384 美元,另加托管费用 | 588 美元 |
这个对比用的是我们的下限。按业界模型估算,仅构建一项就是 658,457 美元。无论哪种情况,决定性的成本都不是租用的组件,而是工程投入:约 4 到 60 个工程师月被用在基础设施上,而不是你的产品上。
你的代码库里留下什么
Desk 是一个基于 ModelRiver 构建的开源客服应用 [7],共有 27,894 行应用代码。其中一个 274 行的文件封装了 ModelRiver 的 API,用于异步请求、重连、对话会话、用量和信号。也就是说,集成代码占这个应用的 1.0%。把所有引用它的文件整体计入,是 15.5%。
Desk 用到了带故障切换的路由、异步推送、流式输出、对话记忆和用量统计。ModelRiver 对这些功能的实现共 22,270 行,相当于整个 Desk 的 80%。单个应用不需要全部这些代码,但哪怕只要其中一部分,大部分代码由谁维护也会随之改变。
最小的可用集成只有两个文件:一个发起请求的后端路由,一个接收结果的前端。我们已端到端运行过:
两个文件合计 22 行代码。要在你的后端信任 ModelRiver 的 Webhook,需要一段 21 行的签名校验。
ModelRiver 在速度上的代价
在应用和服务商之间加一个服务会增加时间。为了只测量 ModelRiver 的那一部分,我们使用了一个总是恰好 200 ms 返回的模拟服务商 [4]:
图 3. 各类请求的中位耗时(接近生产的设置)。青色是模拟服务商固定的 200 ms,橙色是其余部分。异步请求从请求被接受开始计时,接受本身的中位耗时为 24.8 ms。
| 测量项(ms) | 中位数 | p95 | p99 | 重复运行中位数 | 开发默认配置中位数 |
|---|---|---|---|---|---|
| 同步请求,端到端 | 238 | 246 | 253 | 236 | 346 |
| …其中 ModelRiver + 本地网络 | 33.2 | 41.6 | 46.8 | 32.4 | 143 |
| 异步:请求被接受(HTTP 202) | 24.8 | 41.9 | 59.8 | 24.3 | 117 |
| 异步:浏览器连上实时推送 | 2 | 4 | 5.4 | 1.9 | 91.5 |
| 异步:任务在队列中等待 | 7.5 | 9.7 | 11.7 | 7.5 | 7 |
| 异步:接受 → 结果到达浏览器 | 229 | 239 | 266 | 229 | 226 |
| 异步:接受 → 收到签名 Webhook | 252 | 274 | 327 | 252 | 241 |
| 编排:接受 → 你的回调之后的最终结果 | 314 | 373 | 462 | 284 | — |
- 同步请求的中位耗时为 238 ms,其中 33.2 ms 是 ModelRiver 自身的工作(例如认证、限流、查找工作流和记录日志)加上本地网络。同一天的第二次运行结果为 32.4 ms。
- 异步结果在请求被接受后 229 ms 到达浏览器,比服务商本身多约 28.8 ms。经过你自己后端的完整编排往返用时 314 ms。
- 开发模式会误导基准测试。使用服务器的开发默认配置(代码热重载、详细日志)时,同一个请求增加了 143 ms。测试任何网关都请使用生产设置。
- 吞吐量(仅供参考):50 个并发客户端时,这台笔记本每秒处理 168.9 个请求,没有错误。它同时还运行着数据库、模拟服务和客户端,所以这不代表容量上限。
对我们不利的发现
-
SDK 的自动重连对异步请求不起作用。监听令牌按设计只能用一次:第一次连接成功(
join ok),用同一个令牌再连被拒绝(socket rejected)。SDK 的reconnect()会复用已存的令牌,因此同样会被拒绝。通过你的后端调用/ai/reconnect拿到的新令牌可以使用(join ok)。所以页面刷新后的恢复需要你的后端提供一个小路由,我们文档中"自动重连"的说法夸大了实际情况。更新(2026 年 11 月 9 日):已在客户端 SDK 1.8.0 中修复。 现在 ModelRiver 会通过浏览器已建立的连接下发下一个一次性令牌,因此在网络断开、1 小时连接上限或约 5 分钟内的页面刷新之后,SDK 会自动重连,这些情况都不再需要后端路由。中断更久时,传入一个
getToken回调,向你的后端获取新令牌即可。文档现在如实描述了这一点,见重连。 -
SDK 比 README 写的更大。README 写的是"约 15KB(压缩后)",而 v1.7.0 的包压缩后为 37,285 字节,gzip 后为 10,957 字节。
-
投递日志看不出 Webhook 的每次重试。三次自动尝试只留下一条显示"第 1 次尝试"的记录。重试时间本身与文档一致 [15]:3 次尝试,间隔 17.2 秒和 20.1 秒。
我们怎么测的,以及局限
- 代码和历史。脚本从一个 git 提交中读取所有文件,按功能统计行数。一个混合了多个功能、5,650 行的文件被排除在所有功能之外,所以统计偏低。74 项决定都核对过设定它的那一行代码。提交信息中出现 fix、bug、race、crash、leak 或 regression 时计为修复,这只是近似。
- 实测运行。
- 服务器:同一提交的冻结副本,运行在一台 8 核 Apple M1 笔记本上,使用独立的数据库。
- 模拟服务商:OpenAI 格式;成功调用恰好 200 ms,失败立即返回。关闭了响应缓存和输入安全检查。
- 设置:生产构建按设计会拒绝调用本地
http://服务商,所以我们运行开发构建,使用生产日志级别并关闭代码热重载。 - 机器负载:每个场景都在机器负载低于 4 时才开始,并记录了负载。
- 公开数据。
- 事件来自各服务商自己的状态页数据源。OpenAI 按组件报告,重叠分析使用 Chat Completions 和 Responses。
- ModelRiver 的可用性来自其公开状态页。
- 价格为 2026 年 11 月 7 日读取的标价。
- 估算。成本上限使用 COCOMO II.2000 名义设置(A = 2.94,B = 0.91,规模因子之和 18.97)。薪资为美国 BLS 2025 年 5 月软件开发人员的中位数。两者都是公开数据,公式写在数据文件中。
- 这些数据无法告诉你的。ModelRiver 的源代码不公开,所以代码和历史数字由我们报告;外部数据和原始结果是公开的。笔记本上的延迟不等于生产延迟。处于事件中的小时数不等于请求错误率。
如果你正在做决定
- 你可能完全不需要这些:如果你的应用只是同步调用一家服务商,并且服务商宕机时可以直接显示错误。
- 你需要其中大部分,不管是自建还是采购:如果答案必须在请求返回后送到浏览器、需要扛过服务商故障,或者需要在 AI 步骤之间经过你自己的后端。
- 用上面的表格决定哪些部分自建、租用或跳过,以及那 74 项决定里,有多少你不想从教训中再学一遍。
常见问题
AI API 多久出一次故障? 截至 2026 年 11 月 7 日的 90 天里,Anthropic API 有 41.0 小时处于已公布的故障事件中(占 1.9%),OpenAI 文本生成 API 有 55.6 小时(2.6%)。事件从错误率升高到完全宕机不等,OpenAI 的 18 起 API 事件中没有一起被标为完全宕机,所以实际失败的请求比例低于仅看这些小时数时的印象 [1][2]。
多服务商故障切换真的有用吗? 有用,因为服务商很少同时出故障。90 天里 Anthropic 和 OpenAI 的事件只重叠了 0.99 小时。经 ModelRiver 路由并启用故障切换后,暴露在服务商故障中的时间减少了 96–97%,这已经计入 ModelRiver 自身的停机时间 [3][4]。
AI 网关会增加多少延迟? 在我们接近生产的本地测试中,中位数为 33.2 ms(p99 为 46.8 ms)。每次故障切换中位增加 18.4 ms。到网关的网络距离另计,请在你自己的区域测量 [4]。
自建 AI 基础设施要花多少钱? 对于带故障切换的路由、异步推送、签名 Webhook 和编排,根据我们的测量需要 84 到 1,259 个工程师日。按美国软件开发人员薪资中位数计算是 43,932 到 658,457 美元,此外每年约 24 个工程师日用于修复 [4][5][6]。
AI 编排和 AI 网关有什么区别? 网关决定一次模型调用去哪里,以及失败时怎么办。编排管理调用周围的一切:排队、在 AI 步骤之间等待你的后端、超时,以及把结果送到浏览器和你的服务器。ModelRiver 两者都做。
我能核实这些数字吗? 部分可以。事件数、价格、薪资数据和成本模型都来自下方列出的公开来源。你也可以在自己的区域测量 ModelRiver 增加的延迟:把一个工作流设为测试模式(它会在你设定的延迟后返回示例数据,不调用服务商,也不消耗额度),计时一批请求,再减去设定的延迟。代码和历史统计来自我们的私有仓库,所以我们公开结果,但不公开源代码。
参考来源
所有网络来源均于 2026 年 11 月 7 日读取。正文中的方括号编号指向这里。
- Anthropic 状态页及事件数据源(status.claude.com、incidents.json)。2026 年 8 月 9 日至 11 月 7 日标记为 "Claude API (api.anthropic.com)" 的事件。
- OpenAI 状态页(status.openai.com)。API 组件的事件影响记录;重叠分析使用 Chat Completions 和 Responses。
- ModelRiver 状态页(status.modelriver.com)。每分钟对 API 和数据库的健康检查,90 天可用性。
- ModelRiver,本文的原始结果:results-2026-11-07.json(各功能统计、带机器负载的基准测试结果、故障重叠分析、可用性、成本模型输入)和 sources-2026-11-07.md(筛选规则和完整价格表)。
- 南加州大学软件工程中心,《COCOMO II Model Definition Manual》2.1 版,2000 年(PDF)。常数 A = 2.94,B = 0.91,名义规模因子之和 18.97。
- 美国劳工统计局(BLS),职业就业与工资统计,2025 年 5 月:软件开发人员(SOC 15-1252),全国年薪中位数 135,980 美元(职业页面;数据序列 OEUN000000000000015125213)。
- Desk,基于 ModelRiver 构建的开源客服应用(github.com/modelriver/desk)。
- ModelRiver 价格(modelriver.com/pricing)。
- Supabase 价格(supabase.com/pricing)。
- Pusher Channels 价格(pusher.com/channels/pricing)。
- Upstash QStash 价格(upstash.com/pricing/qstash)。
- Hookdeck Outpost 价格(hookdeck.com/outpost/pricing)。
- Svix 价格(svix.com/pricing)。
- Google AI Studio 状态页(aistudio.google.com/status)。
- ModelRiver 文档:Webhook 投递与重试。
延伸阅读:一次简单 AI 请求背后的后端复杂性、为什么 AI 需要不止一次调用你的后端、生产环境里的 LLM Failover,以及文档中的后端流水线和 Webhook 投递与重试。