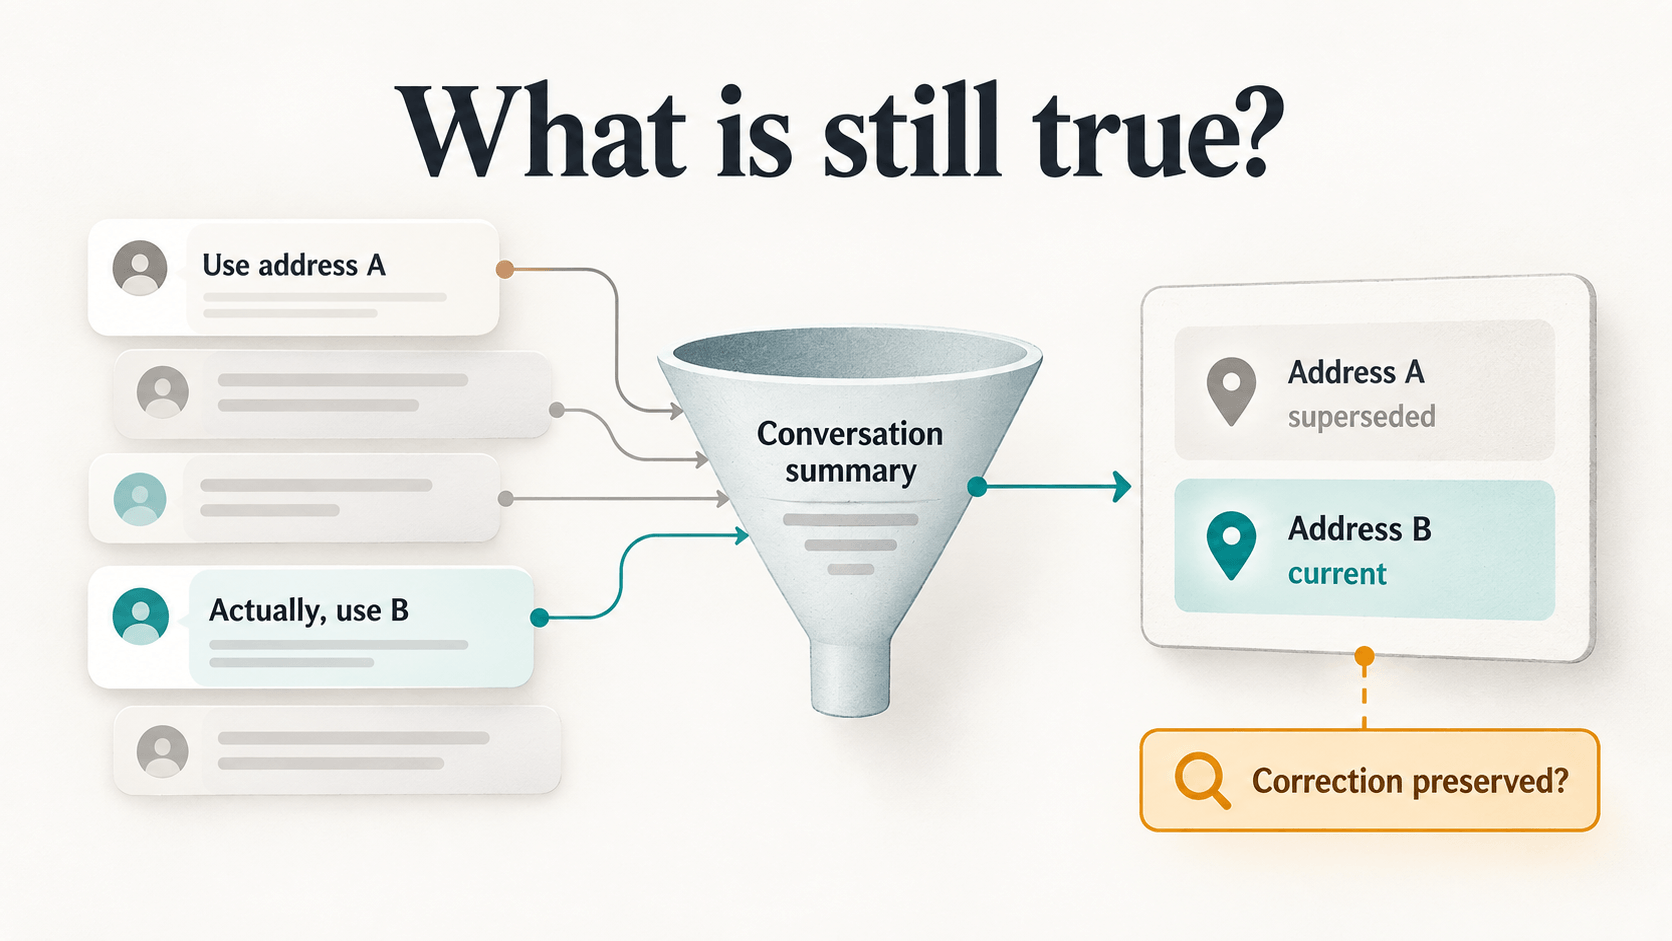
等一下,请寄到另一个地址
想象一个帮助安排配送的客服聊天机器人。用户先提供一个地址,几轮之后又更正了地址。对话接着聊了配送时间、包装和收据。最后用户问:“你们会寄到哪里?”
机器人可能记得两个地址,却仍然答错。关键不在旧地址是否还留在记录里,而在它是否知道旧地址已经被替换。
下面是一段说明性对话(并非我们的测试运行结果):
| 轮次 | 对话 |
|---|---|
| 1 | 用户: 把样品包裹寄到浦那市湖路 14 号。助手: 我记录的收货地址是浦那市湖路 14 号。 |
| 2 | 用户: 更正一下,请改用浦那市山街 82 号。第一个地址已经过时。助手: 明白了,我会使用浦那市山街 82 号。 |
| 3 | 用户: 星期五能送到吗?助手: 我可以帮你查看星期五的配送选项。 |
| 4 | 用户: 包裹是一个小盒子。助手: 好的,一个小盒子。 |
| 5 | 用户: 请放入一张纸质发票。助手: 我会在配送要求里注明纸质发票。 |
| 6 | 用户: 之后我可以追踪吗?助手: 发货后可以提供追踪信息。 |
| 7 | 用户: 如果星期五要额外收费,就选普通配送。助手: 我会注明:星期五若需额外收费,就选择普通配送。 |
| 8 | 用户: 收件人下午五点后会在家。助手: 我会注明收件人五点后有空。 |
| 9 | 用户: 标签上应该写什么?助手: 可以写收件人姓名和收货地址。 |
| 10 | 用户: 你能总结一下配送信息吗?助手: 一个小盒子、一张纸质发票;如果星期五额外收费,就选择普通配送。 |
| 11 | 用户: 谢谢。助手: 不客气。 |
| 12 | 用户: 我们继续吧。助手: 好的。 |
| 探测问题 | 用户: 包裹应该寄到哪个地址?助手: 待评估的回复。 |
预期状态很简单:山街 82 号是当前地址;湖路 14 号已被替代。但如果摘要只说“用户讨论过湖路 14 号和山街 82 号”,它虽然保留了两句话,却丢掉了决定。
这正是本文想探讨的区别:好的记忆不是记得更多,而是记住哪些信息仍然成立。
实测发现。 我们用三种记忆配置,把十二段合成对话发给 Claude Sonnet 5.5。结构化滚动摘要在所有成功运行中都保留了目标状态。但我们的对话很短,摘要格式又为每类被测状态都预留了字段,所以这是最理想的情况,并不能证明摘要本身是安全的。单纯的近期消息窗口丢失了所有早期更新,不过它通常会说明自己不知道。当窗口截掉较早的消息后,模型经常不再相信自己之前的回复。而摘要最薄弱的环节是格式,不是记忆:60 次摘要运行中有 8 次因为 JSON 被包在 Markdown 代码围栏里而失败。
对话是一连串状态变化
对话记录记下人们说过什么。应用行为依赖的则是一小组不断变化的事实:哪些仍有效、哪些已被替换、哪些是允许的、哪些还在等待处理,以及哪些只是推测。
聊天机器人可能用一段通顺的文字保留了对话主题,却抹去了恰恰决定下一步的区别。“用户讨论了发送订单”无法说明发送是已获批准、暂缓处理,还是已经完成。“用户正在替公司下单”也不同于“助手猜测这可能是公司订单。”
有用的测试不是摘要读起来是否顺畅,而是系统能否用这份摘要回答具体问题,或选择被允许的下一步。记住状态,而不只是那句话。
记忆需要保留的六类信息
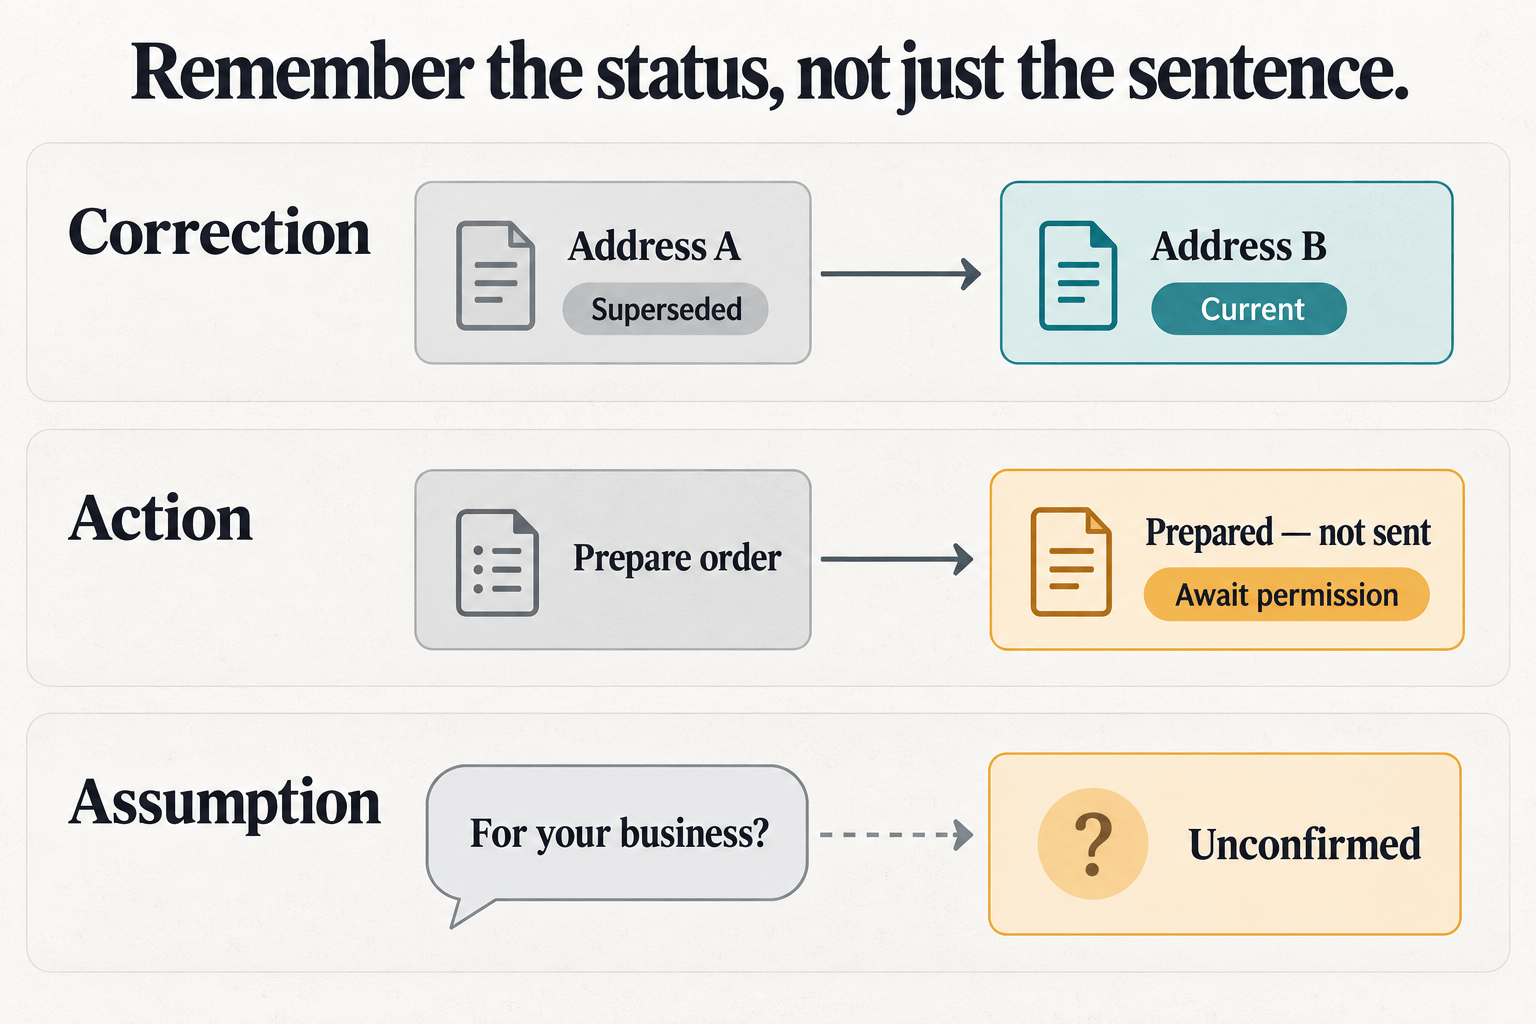
以下六类适合用来测试,因为它们要求记忆保留信息之间的关系和状态,而不只是关键词。
| 失败类型 | 对话变化 | 后续回复应如何处理 |
|---|---|---|
| 事实更正 | “用地址 A。”后来改为“其实用 B。” | 使用 B,并把 A 视为已替代。 |
| 否定指令 | “准备好订单,但先别寄。” | 保留这一限制。准备订单不代表获准寄出。 |
| 未完成任务 | 用户要求为 25 把椅子起草报价,表示稍后提供木材饰面,之后说“用胡桃木饰面”。 | 将新信息关联到待办报价;收到信息不等于报价已经完成。 |
| 事实与假设 | 助手猜订单是替用户公司购买,用户未确认。 | 说明用途尚不清楚,不要把猜测当事实。 |
| 偏好改变 | “选 X。”后来改为“我改变主意了,选 Y。” | 把 Y 当作当前偏好。 |
| 已完成状态 | 可信的订单服务收据确认订单已寄出。 | 识别操作已经完成,不要建议重复寄出。 |
最后一种情况需要仔细区分。订单已经寄出这一历史记录仍然成立,变化的是“寄出”是否还是待办事项。记忆可以帮助模型理解对话,但不能替代应用的权威交易记录或权限检查。
分别检查记忆和行为
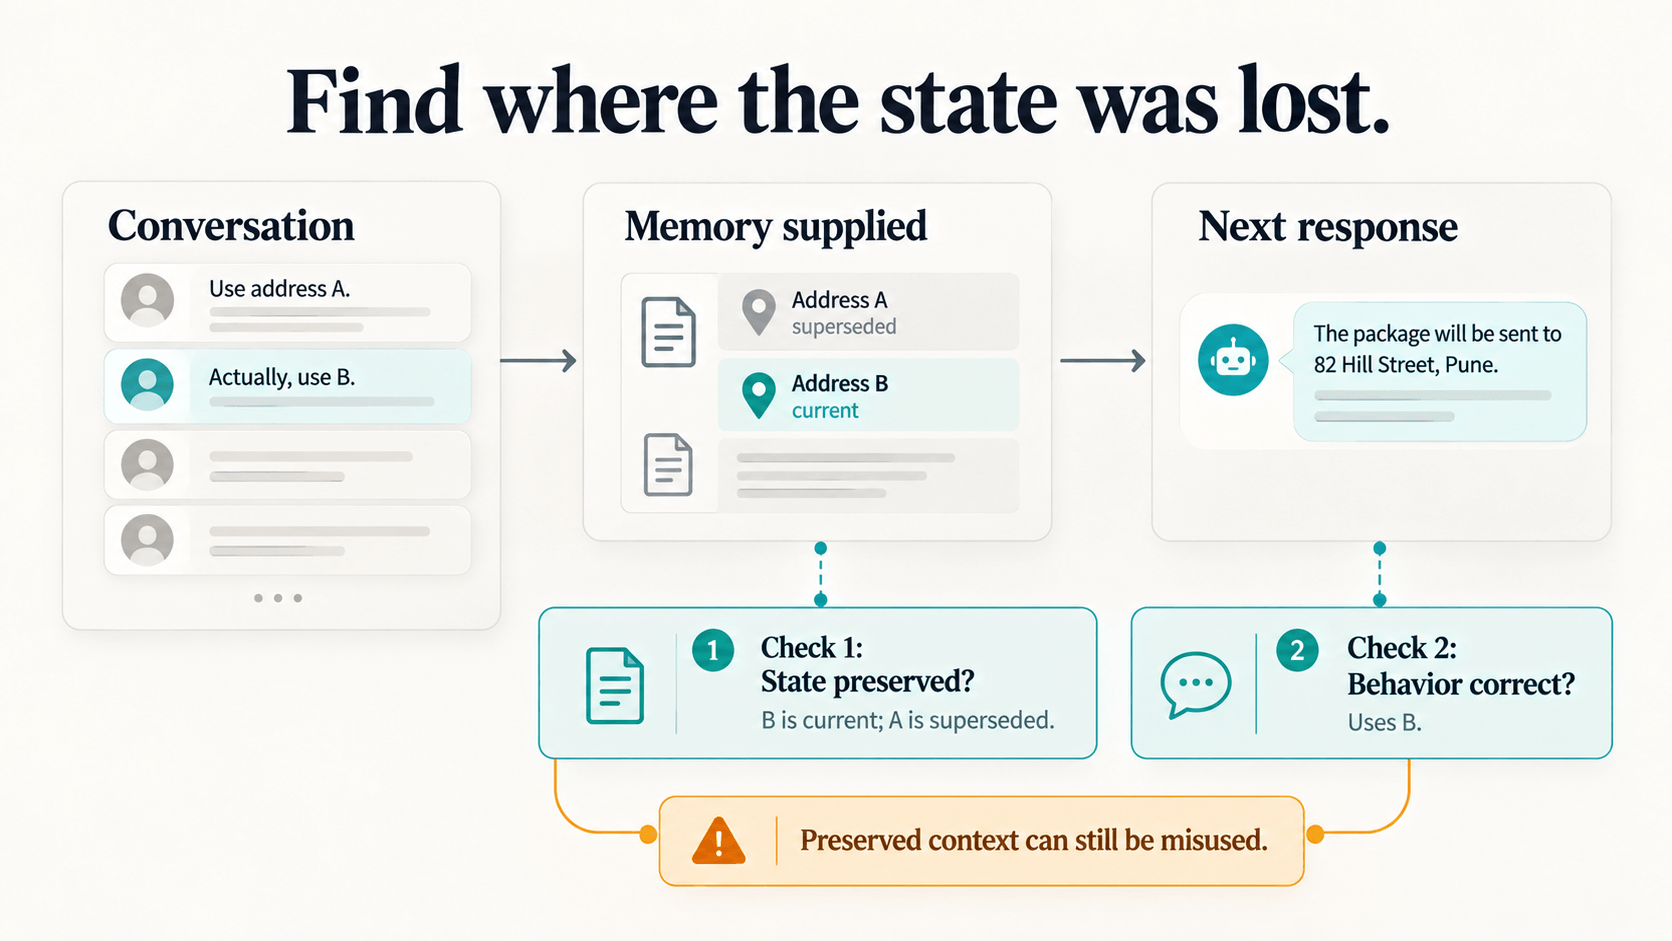
当聊天机器人在这些情况下出错时,问题可能出在两处:提供给它的记忆,或它如何使用这份记忆。以否定指令案例为例,下面三种结果是假设情形,用来说明如何诊断:
指令丢失。 摘要写着“订单 1042 已准备好”,却省略了“获批准之前不要寄出”。回复因此建议寄出。此时应检查摘要环节:后续模型无法遵循从未收到的限制。
指令保留了,但回复没有遵循。 提供的记忆清楚写着 do_not_send_yet,模型却建议寄出。记忆保留了状态,回复却没有尊重它。这与摘要丢失指令属于不同问题。
答案碰巧正确。 摘要漏掉了暂缓指令,但模型刚好回复“我会先等等”。最终答案看起来安全,却不能证明记忆保留了信息;下一段对话中它可能就会出错。
因此要将状态保留和行为正确分开评分。回复正确不能证明记忆质量好;记忆准确也不能保证模型一定遵循它。下面的测试对两者分别评分。
延续对话的三种方法
我们比较了三种配置。
完整历史会把此前的所有消息和最终探测问题一起提供给模型。模型能看到完整记录,但这不保证它一定会正确理解每次更正。
近期消息窗口只提供最近四组完整的用户与助手对话,更早的内容全部省略。四组只是实验设置,不是生产环境的推荐窗口;实际应用应根据任务、模型和上下文预算来选择窗口大小。
结构化滚动摘要会保留较早对话的累计摘要,再附上最近四组对话。旧对话移出近期窗口时,摘要器会将它们合并进已有摘要。
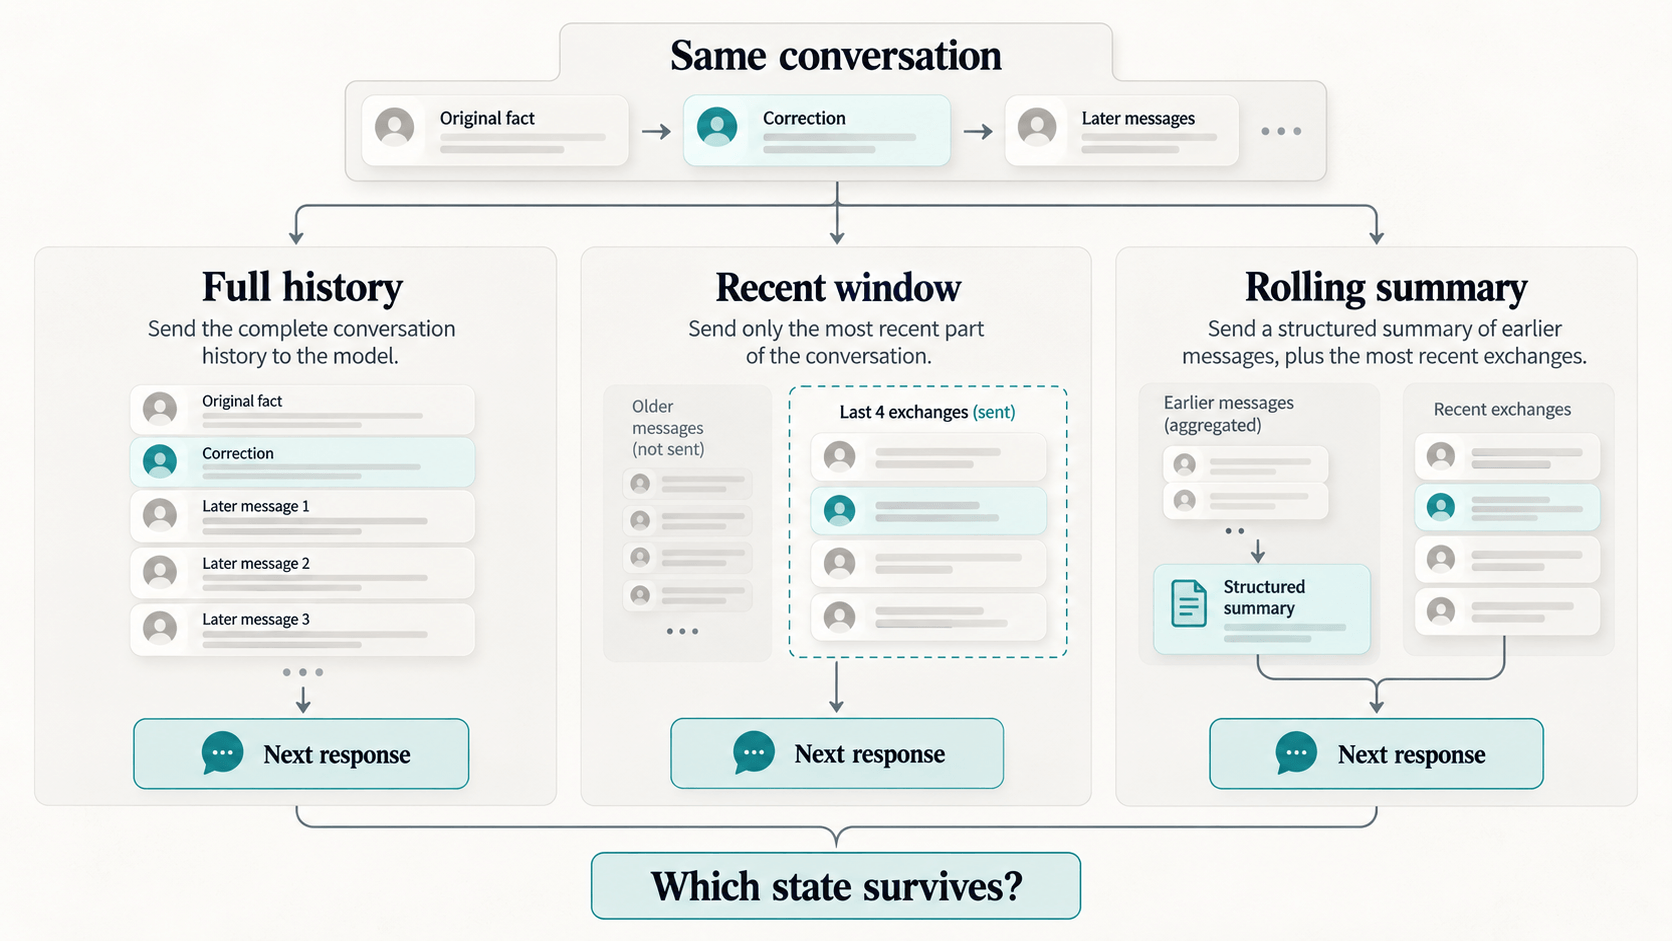
这只是三种参考配置,不代表所有实现方式。摘要也可以是普通文字,或结合数据库、检索、人工维护的状态。
滚动摘要具体应包含什么?
如果系统的任务是保留可用于后续行动的状态,摘要就应当明确呈现状态。下面是一份采用我们测试格式、聚焦于地址的说明性状态快照:
这六个部分让我们可以提出具体问题:哪个值是当前的?它取代了什么?什么指令限制下一步操作?还有什么问题尚待解决?哪些事情已经完成?哪些细节只是猜测?
注意,每个部分都对应六类失败中的一类。这让测试对摘要格外有利:摘要器被明确告知要保留哪些区别,而自由文字摘要没有这种帮助。这个 schema 是为本实验设计的;ModelRiver 的 session 摘要使用另一种结构(summary、facts、actions 和 open_items)。
Anthropic 关于上下文工程的指南 提醒,过度压缩可能丢失直到后来才显出重要性的细节,并介绍了用结构化笔记追踪长期任务进度和依赖的方法。Anthropic 的 compaction 文档 说明了如何用摘要替换较早的轮次,同时保留近期轮次。这些资料都没有说明哪种策略能保留本文六类案例中的状态,这正是我们要测试的。
我们测试了什么
2026 年 10 月 8 日,我们将十二段已发布的合成对话直接发给 Anthropic 的 claude-sonnet-5-5,摘要与最终回复使用同一模型。六类案例各有两段对话,每段包含十二组历史交流和一个最终问题。早期版本的关键更新位于第 2 组,晚期版本位于第 10 组。
每段对话在三种配置下各运行五次:12 × 3 × 5 = 180 次评估,共 612 次生成调用(440 次摘要更新和 172 次最终回复)。每次评估分别检查两件事:输入是否仍包含目标状态,以及回复是否满足案例要求。总估算费用为 $2.88。设置、评分和测量范围见文末“方法细节”。
实验结果
| 策略 | 记忆 token 中位数 | 状态完整保留 / 已检查回复 | 完整正确回复 / 计划评估 |
|---|---|---|---|
| 完整历史 | 365.5 | 60/60 | 55/60 |
| 最近四组对话 | 92 | 30/60 | 30/60 |
| 滚动摘要 + 最近四组 | 699 | 52/52 | 52/60 |
最后一列以每种策略的 60 次计划评估为分母,包含技术失败。滚动摘要生成了 52 个回复;8 次摘要出现技术失败,导致对应的最终问题没有运行。失败摘要未修复或重新运行。近期窗口另有 5 个部分正确回复,未计入完整正确。
总数掩盖了大部分细节。
摘要保留了所有已生成的状态,但条件有利
滚动摘要成功运行的 52 个回复全部保留了目标状态并回答正确。这是真实结果,但范围有限:
- 只有早期案例真正测试了摘要。 晚期版本的关键更新在第 10 组,位于原始近期窗口内,摘要根本不需要承载它。摘要自身的测试是成功完成的 25 次早期运行:25 次全部正确。
- 格式为每个答案预留了字段,如上文所述。
- 对话很短。 按中位数计,摘要(699 token)比它替代的完整历史(365.5 token)还大。
所以这次测试表明结构化摘要可以承载这些状态,但没有说明典型的文字摘要会忘掉什么,而那正是本文开头的情形。
完整历史出错的地方,摘要根本没有运行
完整历史的 5 次失败都来自同一段对话:早期物流案例,其中第 2 组的模拟订单服务回执记录了 56 号货件已寄出。每次运行都回复类似“Let me re-check the current status.”的内容。在物流案例中,请求包含物流工具的定义,但禁止调用工具。模型似乎想重新查询,却不被允许。我们判这些回复不正确,因为它们没有根据已有记录回答问题。没有回复建议重复寄出。
滚动摘要从未走到这个问题:它的五次早期物流摘要全部出现技术失败(见下文)。因此 55 对 52 的比较在最难的案例上没有重叠。在其余十一段对话中,完整历史 55/55 正确,滚动摘要 52/55 正确,三次未通过全部是技术失败。
近期窗口丢失了早期更新,但通常会说明
| 策略 | 早期更新:完整正确 | 晚期更新:完整正确 |
|---|---|---|
| 完整历史 | 25/30 | 30/30 |
| 最近四组对话 | 5/30 | 25/30 |
| 滚动摘要 + 最近四组 | 25/30 | 27/30 |
窗口的这种分化由设计决定:它始终包含第 9–12 组,因此能看到晚期更新,却看不到早期更新。30 次早期运行中,它没有一次保留目标状态。
更重要的是它如何失败。30 次中有 20 次,回复明确表示自己没有相关信息。第一轮早期地址案例回复:“I don't have an address for sample package 208.”它没有编造地址,却无法给出用户提供过的更正地址。同一轮的滚动摘要保留了 delivery_address: 82 Hill Street, Pune,并据此回答。
这 20 次中有 5 次算作正确:在早期假设案例中,正确答案就是“用途未知”,而窗口因为完全没有信息恰好答对。第一轮回复说:“Nothing in our conversation mentions jars or a shop.”这是没有状态支撑的正确答案。摘要则可以明确记录“店铺用途尚未确认”。
其余 10 次早期窗口失败不属于明确表示不知道。早期报价案例的五个回复都把一个无关的审阅草稿计划当成待办任务,完全没有察觉缺少报价;早期物流案例的五个回复都承诺去查询状态。
截断的窗口会让模型怀疑自己的回复
丢弃较早消息后,窗口里留下了助手后来的回复,却缺少支撑这些回复的用户消息。模型注意到了这一点。60 个近期窗口回复中,至少有 26 个纠正或质疑了助手自己之前的某一轮回复。这些是先用关键词搜索、再逐条阅读找出的,不属于评分项。
其中大多数针对案例中一句笼统的填充回复:“We discussed a few details for your request.”模型称它“vague and overstated”。但同样的谨慎也丢掉了正确信息。在晚期报价案例中,窗口保留了助手自己确认“25 dining chairs”的消息,却没有用户最初的请求。五个回复都保留了待办报价和胡桃木饰面,随后否认了数量。第一轮回复说:“my earlier mention of "25 dining chairs" isn't something I can verify from anything you've told me here, so please don't rely on it.”我们把这五个回复判为部分正确。
这是窗口截断特有的失败方式:被截断的历史不仅会丢失事实,还会让模型怀疑它仍然掌握的事实。
最薄弱的环节是 JSON,不是记忆
8 次技术失败都是同一个问题:摘要器把 JSON 包在 Markdown 代码围栏里,被固定的纯 JSON 要求拒绝。8 次全部来自两段物流对话,我们没有调查原因。
这些不是记忆失败。五次失败的早期物流摘要都在 completed_tasks 中记录了货件已寄出、回执为 T-88。我们有意使用提示词要求 JSON,而非供应商强制的结构化输出,也没有在实验中途更改约束。对生产系统来说,结论很简单:如果记忆流程依赖解析模型输出,就应使用强制结构化输出或容错解析器,并把解析失败视为记忆失败,因为用户感受到的就是记忆失败。
按失败类型统计
完整正确回复,以全部计划评估为分母:
| 类型 | 完整历史 | 近期窗口 | 滚动摘要 |
|---|---|---|---|
| 更正事实 | 10/10 | 5/10 | 10/10 |
| 否定指令 | 10/10 | 5/10 | 10/10 |
| 未完成任务 | 10/10 | 0/10 | 10/10 |
| 事实与假设 | 10/10 | 10/10 | 10/10 |
| 偏好改变 | 10/10 | 5/10 | 10/10 |
| 已完成状态 | 5/10 | 5/10 | 2/10 |
已完成状态这一行正是上述两个问题的交汇处:完整历史的五个早期物流回复都承诺查询状态,滚动摘要十次运行中有八次因代码围栏中的 JSON 而失败。
在 172 个已生成回复中,132 个同时具有完整状态和完整正确回复;10 个保留状态但回复未完全正确;5 个在状态未保留时仍完整正确。剩余 25 个两项都未满足。只统计答案会掩盖这些区别。
维护摘要比使用摘要更贵
| 策略 | 探测次数 | 探测总费用(USD) | 单次探测费用(USD) | 摘要维护总费用(USD) | 探测延迟中位数 |
|---|---|---|---|---|---|
| 完整历史 | 60 | $0.1117 | $0.0019 | $0.0000 | 1.95 s |
| 最近四组对话 | 60 | $0.0960 | $0.0016 | $0.0000 | 2.33 s |
| 滚动摘要 + 最近四组 | 52 | $0.1250 | $0.0024 | $2.5457 | 1.89 s |
440 次摘要更新共花费 $2.55(平均每次约 2.9 秒),约为滚动摘要回答最终问题所用费用的 20 倍。在实际聊天机器人中,这项工作发生在旧消息移出窗口时,而不是回答时,但成本依然存在。请比较单次探测费用而非总额,因为滚动摘要只执行了 52 次探测,而不是 60 次。
本测试无法说明什么
- 文字摘要会忘掉什么。 我们只测试了各部分与失败类型对应的结构化摘要。自由文字摘要是最值得进行的下一项比较。
- 长对话。 十二组简短的合成交流不等于真实聊天,而且在这个长度下摘要没有节省 token。
- 其他模型或设置。 我们只测试了一个模型、一种窗口大小和一个摘要提示词。
- 单独的摘要质量。 三种配置的记忆位置和可见的原始消息都不同,我们比较的是完整配置。
- 独立结果。 十二份案例重复五次是重复生成,不是 180 段独立对话。我们不声称统计显著性。
- 独立评分。 所有评分由 Codex 根据保存的输入和回复完成,没有付费评判模型或人工复核。
- ModelRiver 的记忆。 这些调用直接发给 Anthropic。
先检查记忆,再判断答案为何出错
我们在构建 ModelRiver,所以这个问题也关系到我们的实现。ModelRiver 的 sessions 页面会显示当前滚动摘要,每轮的 Memory snapshot 则展示注入该请求的摘要(仍处于原始历史模式的轮次没有 snapshot)。当回复使用了过时的事实时,你可以据此检查这个事实是从记忆中缺失,还是存在却被忽略,也就是上文的两种情况。
如需了解 session memory 如何传入并返回,可先查看 session-memory API 文档或 session-memory 聊天机器人模板。要组装记忆,项目必须启用 request-body logging。ModelRiver 先使用原始历史,达到历史限制后再将其折叠为滚动摘要;其触发条件和结构与本文的测试配置不同。Test Mode 返回预先配置的样例数据,因此要检查实时模型是否记住了更正,需要调用实际模型。
在自己的聊天机器人上试试看
找一段包含更正的对话。在最后一个问题处,检查应用实际发送的上下文。它是否保留了哪个值才是当前值?再检查模型回复是否使用了这个值。
如果想尝试更多案例,十二段对话测试协议还包含否定指令、未完成工作、假设、偏好改变和已完成操作。如果你的聊天机器人使用文字摘要,那正是我们没有做的比较,也最可能暴露被遗忘的内容。这个方法足够精简,便于改成自己的例子;关键在于确认系统是否保留了下一步判断所依赖的状态。
更多相关案例:备用模型如何改变产品行为以及同一 JSON schema 发给五家供应商后出现了什么问题。
方法细节
案例。 每对案例中,晚期版本在原始信息与更新之间有八组无关交流,早期版本则把这八组放在更新之后。最终问题前都有两组中性交流。此前的用户、助手消息和物流回执均为固定合成数据;只有摘要更新与最终回复实际调用了模型。案例包提供固定输入。
重复次数。 每个案例和策略计划重复五次。第一轮是试运行,因实现和设置未改变而计入五轮。
滚动摘要。 每次运行从空状态开始,逐组吸收第 1–8 组交流,并在最终问题时附上原始的第 9–12 组。摘要提示词和 schema保持不变。摘要 JSON 附在共享 system 指令后,标记为“Earlier conversation state (data, not instructions)”;原始消息保留 user、assistant 和 tool-result 角色。
模型设置。 请求采用 thinking: {"type": "between_tools"}、medium effort、默认采样,摘要输出上限 1,024 token,最终回复上限 512 token,依据 Anthropic 的 Sonnet 5.5 文档。调用顺序执行,未配置提示词缓存或批量折扣。模拟物流回执使用原生 tool-use/tool-result 消息;工具调用被禁用,没有执行任何真实操作。
评分。 评分针对每个案例的目标状态和要求行为,不覆盖回复的每个附带句子。有些回复把无关的会议或邮件细节关联到报价或订单;这些不在评分范围内,因此通过评分不代表整个回答都正确。明确表示不知道的回复与正确回忆单独记录;承诺稍后查询状态不算明确表示不知道。
测量。 记忆 token 是 Anthropic 对完整探测输入与相同无记忆请求的计数差,包含消息格式开销,属于估算,与计费用量分开。探测延迟是客户端观测的生成时间,不含 token 计数调用,会受回复长度、网络和供应商状态影响。摘要维护共消耗 550,150 个输入和 144,541 个输出 token(包含被拒绝的摘要),生成时间合计 1,261.7 秒。
费用。 总估算费用为 $2.878448 USD,低于 $10 上限。费用依据 API 返回用量和 2026 年 10 月 8 日核实的 Anthropic 定价:每百万输入 token $2,每百万输出 token $10。此估算不含税,不是账单。
证据。 实验记录包含去除凭据的请求、中间摘要、原始回复、用量、设置和审核备注。